


Pourquoi votre agent IA écrit des tests Appium qui ne passent pas
Réponse courte : vous avez demandé un test de paiement à votre agent, il a écrit 60 lignes d'Appium en dix secondes, et l'exécution est morte à la ligne 4 sur un identifiant absent de votre build. Ce n'est pas un problème de prompt — l'agent n'a jamais vu votre application. Donnez-lui le vrai arbre d'éléments, le vrai trafic réseau et le vrai résultat d'exécution, par une seule connexion vers du matériel réel, et il cesse de deviner.
Où passent réellement les heures
Personne ne passe un après-midi à taper un test. L'esquisse d'un parcours connexion-puis-paiement prend dix minutes.
Ensuite, l'identifiant que vous aviez deviné n'existe pas dans le build. L'attente porte sur la mauvaise chose. Une boîte de dialogue d'autorisation dont personne n'avait parlé avale le premier appui. L'API renvoie l'état vide parce que le compte n'a aucune commande. Chacun de ces points est un aller-retour complet — lancer sur un appareil, lire l'échec, corriger, relancer — et chaque aller-retour coûte cinq à dix minutes. Vingt d'entre eux, c'est la journée.
Confiez le travail à un agent IA et la boucle ne change pas. L'agent tape plus vite, donc il atteint la boucle plus tôt. Il écrit toujours un localisateur qu'il n'a pas vu, exécute toujours, échoue toujours, et attend toujours que vous lui colliez la trace d'erreur. Mieux formuler le prompt n'y change rien, parce que le problème n'est pas la formulation : l'agent raisonne sur une application qu'il n'a jamais regardée.
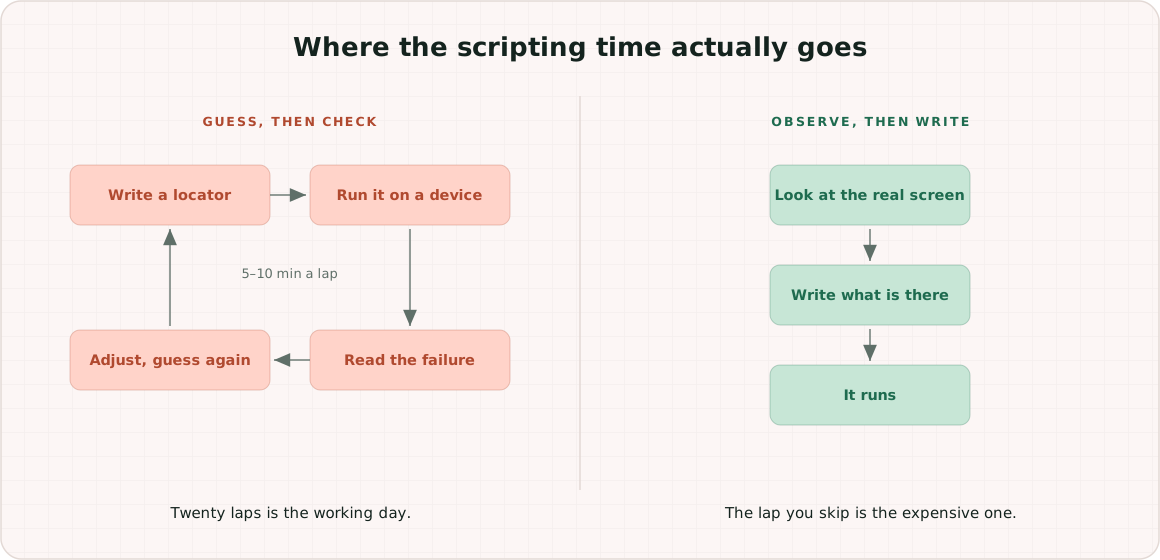
Un agent a besoin de l'écran, pas d'une description de l'écran
Écrivez ce que fait une personne avant de choisir un localisateur. Ouvrir l'écran. L'inspecter. Lire les identifiants réellement présents. Appuyer sur quelque chose. Regarder ce qui a changé.
Chacune de ces étapes est une observation, et aucune ne survit à sa mise en résumé dans un prompt. Les outils que nous avons construits sont donc ces mêmes quatre choses, pointées vers du matériel réel :
- l'arbre d'éléments de ce qui est à l'écran maintenant, avec des éléments nommés et adressables
- ce qui s'est passé après une action — une capture, le nouvel arbre, les journaux
- le trafic produit par l'application pendant ce temps
- le résultat de l'exécution, ensuite
Un agent qui dispose de cela écrit le localisateur qui existe, au lieu de celui qui sonne juste.
De vrais éléments, pas quarante conteneurs imbriqués
React Native sur iOS en est la version la plus nette. Pointez un inspecteur courant sur un écran React Native et vous obtenez une pile de conteneurs imbriqués dont aucun n'est visiblement « le bouton » — l'agent se rabat alors sur un XPath qui décrit où se trouvait l'élément ce jour-là, et le test casse au changement de mise en page suivant.
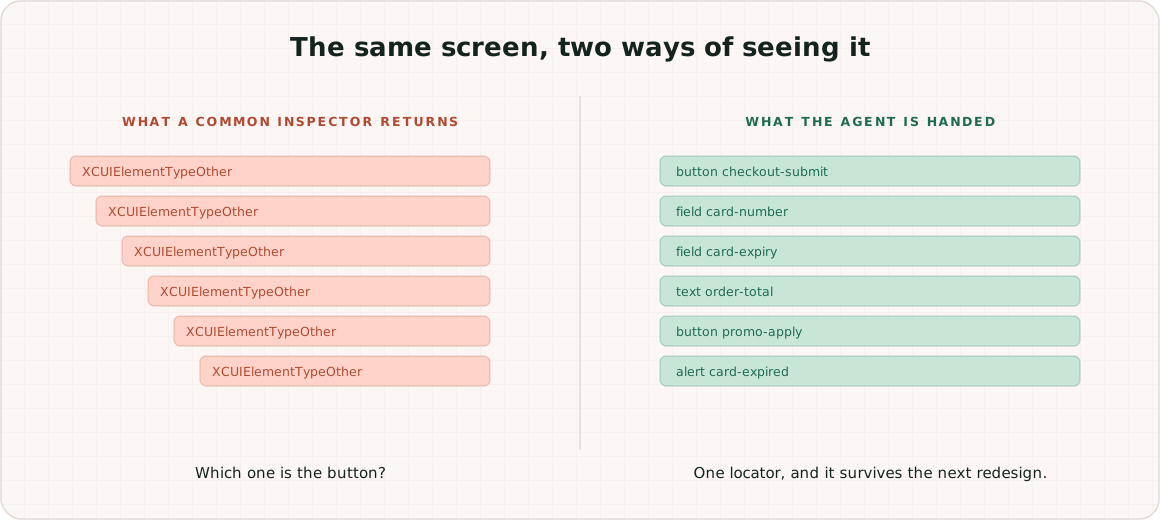
Dans notre inspection, une application React Native apparaît comme n'importe quelle application native : des éléments nommés que l'agent peut adresser directement, sur iOS comme sur Android. Un seul localisateur pilote alors les deux plateformes au lieu de deux. Il existe un article plus détaillé là-dessus si c'est le problème qui vous amène.
Les deux plateformes cessent d'être deux problèmes
L'asymétrie entre iOS et Android est l'endroit où le travail d'automatisation meurt discrètement : inspection différente, attentes différentes, gestion de fichiers différente, tout différent — si bien que la moitié de votre suite est du code spécifique à une plateforme qui fait deux fois la même chose.
Un agent appelle les mêmes noms d'outils des deux côtés. Attentes sur élément, requêtes par région, suggestions de localisateurs, fichiers vers et depuis l'appareil, gestes de n'importe quelle forme, journaux système. Changez la langue de l'appareil, ou lancez une seule application dans une autre langue en laissant le reste du téléphone tranquille — sans passer par les Réglages, sur l'une comme sur l'autre. Là où les deux systèmes diffèrent réellement, la différence est absorbée chez nous plutôt que de surgir dans le contexte de votre agent sous forme de cas particulier.
Une chose mérite d'être dite clairement plutôt qu'esquivée : l'automatisation iOS exige un Mac quelque part. Le nôtre, pas le vôtre, mais l'exigence existe.
Ce que l'agent peut réellement atteindre
Tout ce qui suit passe par la même connexion, sur les deux plateformes :
- Piloter l'appareil comme le fait une personne — appuis tactiles proches d'un vrai doigt, gestes multi-touch, tracés de geste de n'importe quelle forme, vraies frappes clavier, et une manette de jeu si l'application en accepte une.
- Changer l'appareil sous l'application — langue de l'appareil ou d'une seule application, thème clair ou sombre, position GPS, orientation — sans passer par les Réglages.
- Voir ce que fait l'application — arbres d'éléments avec suggestions de localisateurs, informations d'accessibilité, journaux système en direct, rapports de plantage et compteurs de performance.
- Inspecter, restyler et intercepter le contenu web — DOM, CSS, console, interception réseau et simulation de réponses, via le Chrome DevTools Protocol sur Android comme sur Safari iOS.
- Capturer et simuler le réseau — trafic web comme natif, ce qui est l'objet de la section suivante.
- Exécuter les suites que vous avez déjà — Selenium, Appium, Playwright et WebdriverIO, sur ces mêmes appareils et sur de vrais navigateurs de bureau de la grille.
La liste compte moins que la propriété qu'elle possède : l'agent n'a pas à sortir de son cadre, et il n'a pas à vous demander d'aller faire à sa place l'étape qu'il ne peut pas atteindre.
C'est aussi par là que cela dépasse ce qu'offre une session WebDriver. Appium est le bon outil pour piloter une application et vos suites continuent de l'utiliser — rien ici ne le remplace. Mais une session WebDriver a pour périmètre le pilotage : dans la même session, elle ne vous donnera pas en plus le trafic réseau natif de l'appareil, un plantage symbolisé et regroupé avec ses semblables, une manette de jeu, un audit d'accessibilité, ou le CSS d'une page dans une webview. Ce sont d'ordinaire quatre outils et un dossier de scripts de colle. Ici, c'est une seule connexion — et c'est pour cela qu'un agent tient l'image entière au lieu d'en recevoir une tranche.
Le navigateur sur l'appareil, pas un substitut
Les bugs du web mobile vivent dans le navigateur mobile. Une fenêtre Chrome de bureau réduite à 390 px de large est un aperçu de mise en page, pas ce que rencontrent vos utilisateurs.
L'agent obtient donc sur le navigateur de l'appareil la même catégorie de contrôle que Playwright lui donne sur un navigateur de bureau. Naviguer, évaluer du JavaScript dans la page, lire et interroger le DOM. Modifier le CSS et voir la mise en page réagir. Lire et poser des cookies, suivre la console, intercepter le réseau, simuler une réponse. Sur Chrome Android comme sur Safari iOS, par le Chrome DevTools Protocol standard des deux côtés.
iOS est la moitié qui s'accompagne d'habitude d'un astérisque ; ici, non. L'interception et la simulation de réponses accompagnent l'inspection : votre agent obtient la même forme de contrôle qu'en pilotant Playwright, et il ne cible qu'un seul protocole.
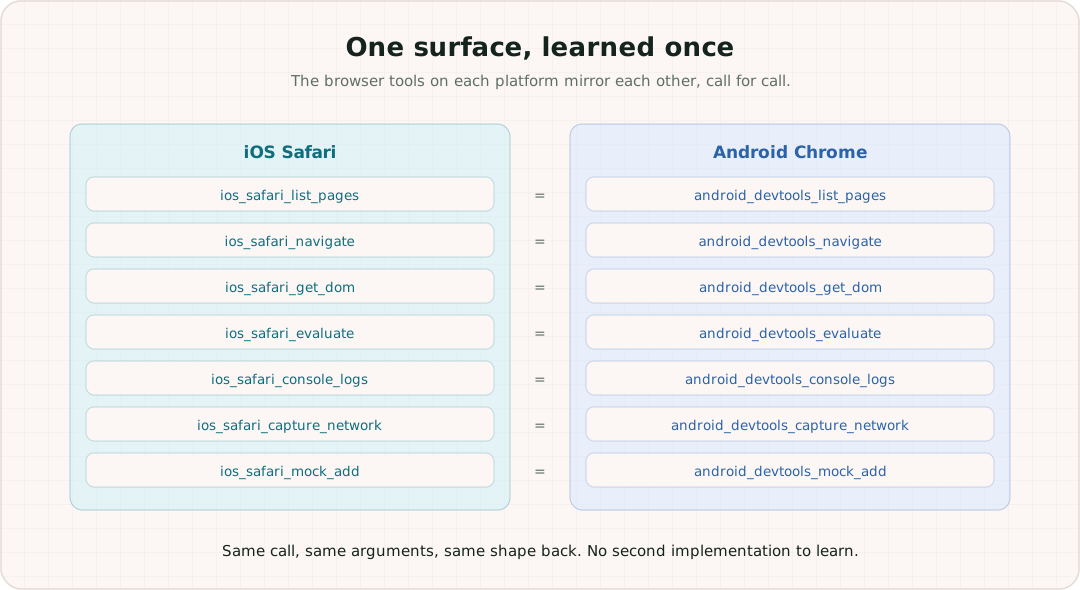
Concrètement, « reproduire le bug dans le vrai navigateur mobile » cesse d'être un projet à part. C'est la même connexion, à un appel d'outil du côté natif de la même application.
De vrais navigateurs de bureau sont également disponibles sur la grille, pilotés par Selenium, Playwright ou WebdriverIO, si bien qu'une même suite couvre les deux sans changer d'endroit d'exécution.
De vraies données, pas une imitation plausible
L'écran n'est que la moitié du tableau. L'autre moitié est ce que l'application dit réellement sur le réseau, et cela inclut le trafic natif — pas seulement ce que fait un onglet de navigateur. La capture fonctionne pour le contenu web et natif, sur les deux plateformes.
C'est déterminant pour la vitesse de scripting, parce que l'agent peut voir la requête qui a produit l'état vide, puis simuler la réponse pour provoquer cet état à la demande. Un bug intermittent que vous n'arriviez pas à reproduire devient un test à entrée fixe. La boucle « essai-erreur » est remplacée par quelque chose sur quoi on peut assertir.
Puis il relit sa propre copie
Les exécutions Selenium et Appium lancées sur la grille sont également lisibles par l'agent. Pas seulement réussite/échec : ce qu'a fait la suite, quelle étape a échoué, ce qu'elle a touché, et un diagnostic du pourquoi. L'agent qui a écrit le test peut regarder l'exécution et le corriger, sans qu'une personne transporte une trace d'erreur d'une fenêtre à l'autre.
C'est la partie qui compose. La boucle existe toujours — elle existera toujours — mais elle se referme sans que vous soyez au milieu.
Un scénario, trois usages
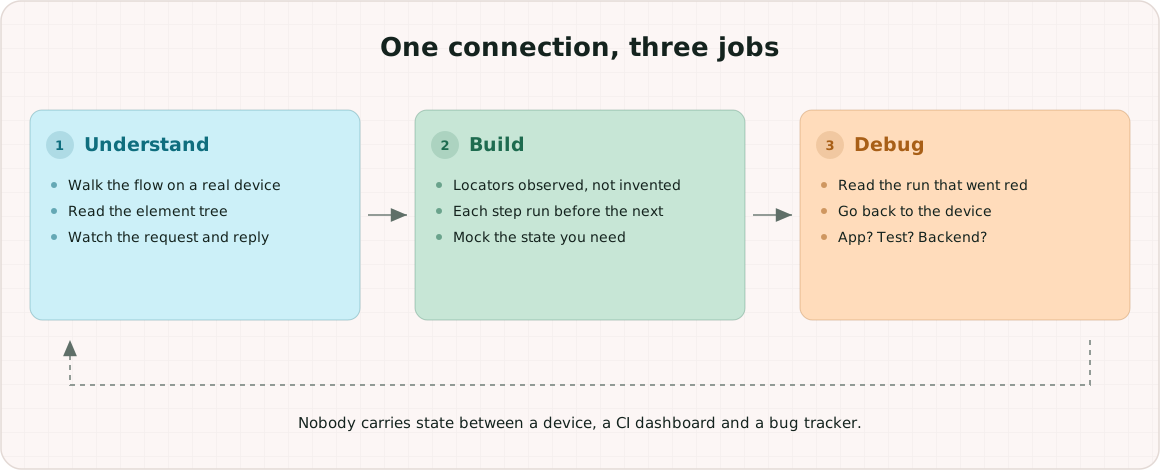
Prenons un vrai ticket : le paiement échoue pour les clients dont la carte enregistrée a expiré, mais seulement sur mobile. Voici la même connexion faisant trois travaux différents.
Le comprendre. L'agent installe le build sur un vrai téléphone et parcourt lui-même le parcours. Il ne vous demande pas de décrire les écrans : il lit l'arbre d'éléments à chaque étape et récupère des éléments nommés et adressables, sur iOS comme sur Android. Là où le paiement est web, il pilote le navigateur de l'appareil : évaluer un peu de JavaScript, lire le DOM, récupérer la console, observer la requête partir et la réponse revenir. En quelques minutes, il peut vous dire quelle étape rejette la carte et ce que le serveur a réellement répondu, plutôt que ce que le ticket prétend qu'il a répondu.
Construire l'automatisation. Les localisateurs sont désormais observés et non inventés. L'agent écrit le test et exécute chaque étape sur l'appareil au fur et à mesure : une étape est confirmée avant que la suivante ne soit écrite. Quand il lui faut l'état « carte expirée » à la demande, il simule cette réponse au lieu d'attendre qu'un compte de test vieillisse jusqu'à la bonne condition — et le même procédé couvre l'état vide, le délai d'attente et le 500 que votre backend ne produira pas sur commande. Ce qui arrive dans le dépôt a déjà été exécuté au vert une fois.
Le déboguer. Six semaines plus tard, le test passe au rouge dans la CI. L'agent lit l'exécution depuis la grille — quelle étape, quel élément, la capture au moment de l'échec — puis revient à l'appareil vérifier le comportement réel : capturer le trafic, lire le journal système, regarder l'arbre d'éléments tel qu'il est maintenant. C'est ce qui distingue l'application a changé, le test était fragile et le backend est réellement cassé. Ces trois cas ont des correctifs différents, et se tromper de diagnostic coûte une journée.
Aucun de ces trois travaux n'est nouveau. Ce qui change, c'est qu'ils se font tous sans qu'une personne transporte l'état entre un appareil, un navigateur, un tableau de bord de CI et un outil de suivi de bugs.
Concrètement, les appels derrière ce parcours :
# le comprendre
device_launch_app_in_language      ouvrir le build dans la locale testée
device_page_source                 l'arbre d'éléments tel qu'il est
device_locators_for                par quoi adresser cet élément
ios_safari_get_dom                 le paiement web, dans le navigateur de l'appareil
ios_safari_console_logs            ce dont la page s'est plainte
ios_traffic_start / _flows         la requête qui a rejeté la carte

# le construire
device_find_element                des localisateurs observés, pas inventés
device_wait_for_element            attendre un état plutôt qu'un sleep()
device_tap / device_type           piloter et confirmer chaque étape
ios_safari_mock_add                forcer la réponse « carte expirée » à la demande

# le déboguer
automation_sessions_list           retrouver l'exécution passée au rouge
automation_session_step            quelle étape, quel élément, la capture
automation_report                  le diagnostic
ios_accessibility_audit            libellés et ordre de lecture, si c'est l'accessibilité
jira_create_issue                  déclarer l'anomalie avec les preuves jointes
Reprenez la colonne iOS et changez le préfixe : android_devtools_get_dom,
android_devtools_console_logs, android_traffic_start, android_accessibility_audit. Les deux
familles se reflètent délibérément — c'est ce que « pas de seconde implémentation » veut dire en
pratique : votre agent apprend la surface une fois.
Le tout par une seule connexion
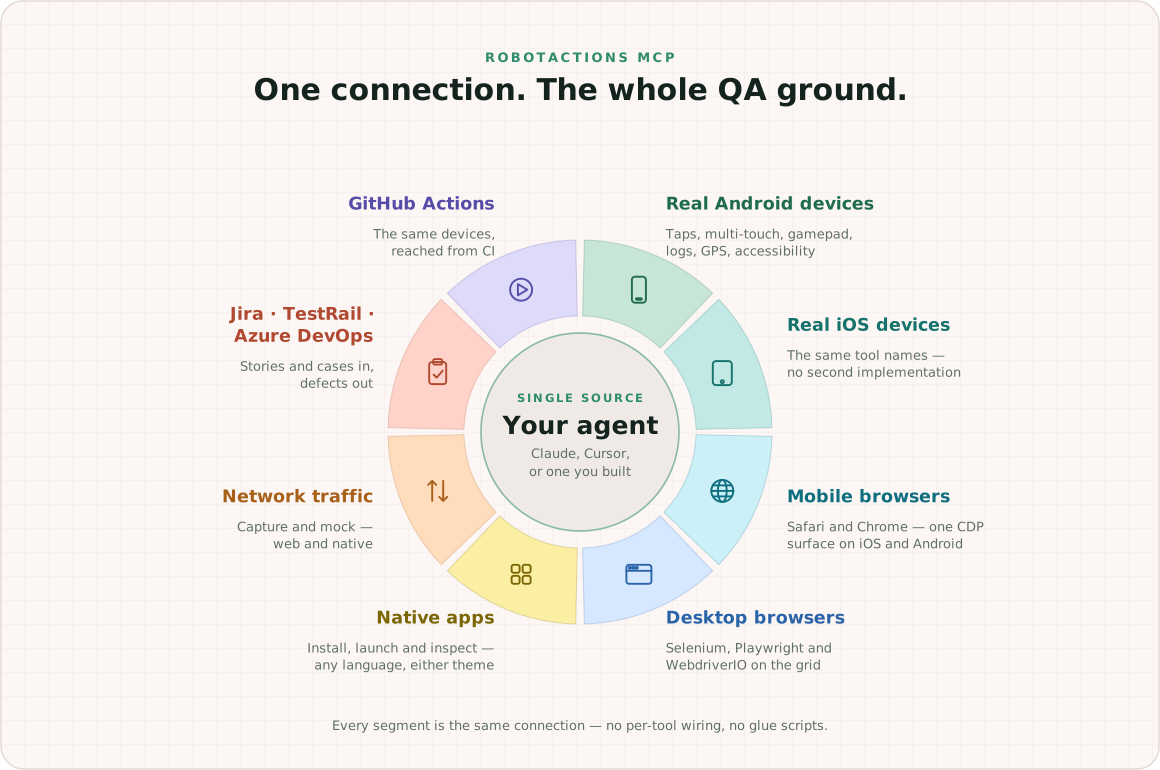
Des appareils réels, de vrais navigateurs mobiles et de bureau, l'application installée dessus, le trafic qu'ils produisent, et les outils dans lesquels le reste de l'équipe vit déjà. La couverture de la chaîne de gestion des tests est complète et non symbolique : l'agent lit les récits et les critères d'acceptation, récupère et met à jour les cas, et déclare les anomalies dans Jira, TestRail et Azure DevOps. Les mêmes appareils sont accessibles depuis la CI via une GitHub Action publiée.
Du récit au test, du test à l'exécution, de l'exécution au diagnostic, puis à l'anomalie — sans personne pour relayer les résultats entre quatre onglets. Un point de terminaison, une authentification, aucun script de colle à maintenir par outil.
Ce que nous visons vraiment
Pas « l'IA écrit vos tests à votre place ». Cette promesse vend un raccourci, et les raccourcis sont la raison pour laquelle tant de code de test généré finit supprimé en revue.
L'objectif est plus étroit et plus utile. Un agent doit pouvoir se servir d'un appareil réel aussi librement qu'une personne : le prendre en main, essayer quelque chose, regarder ce qui s'est passé, essayer la suite. Changer la langue et voir ce qui casse. Forcer l'état d'erreur et observer l'écran. Lire le journal quand quelque chose cloche.
La compréhension naît de cette liberté, et c'est la compréhension qui compte. Une automatisation écrite par quelque chose qui a réellement manipulé votre application est plus solide que celle écrite par quelque chose à qui on l'a décrite : les localisateurs existent, les attentes portent sur des états réels, et les cas limites sont ceux qu'il a vus se produire plutôt que ceux qu'il a imaginés.
Voilà tout le cahier des charges. Donnez l'appareil à l'agent, honnêtement et entièrement, et les bons scripts de test en découlent au lieu d'être un tour de passe-passe.
Essayez-le sur un parcours complet
npx @robotactions/mcp@latest initL'offre gratuite, c'est un appareil et dix minutes de temps d'appareil par jour, ce qui suffit à savoir si l'argument tient. Donnez à votre agent un parcours que vous repoussez depuis un moment, et regardez où il cesse de deviner.
Articles liés
Prêt à tester sur de vrais appareils ?
Connectez-vous avec Google ou GitHub et accédez à de vrais appareils iOS et Android depuis votre navigateur — gratuit à l'essai.